蔚藍檔案,這次的主題又是你激發出來的。
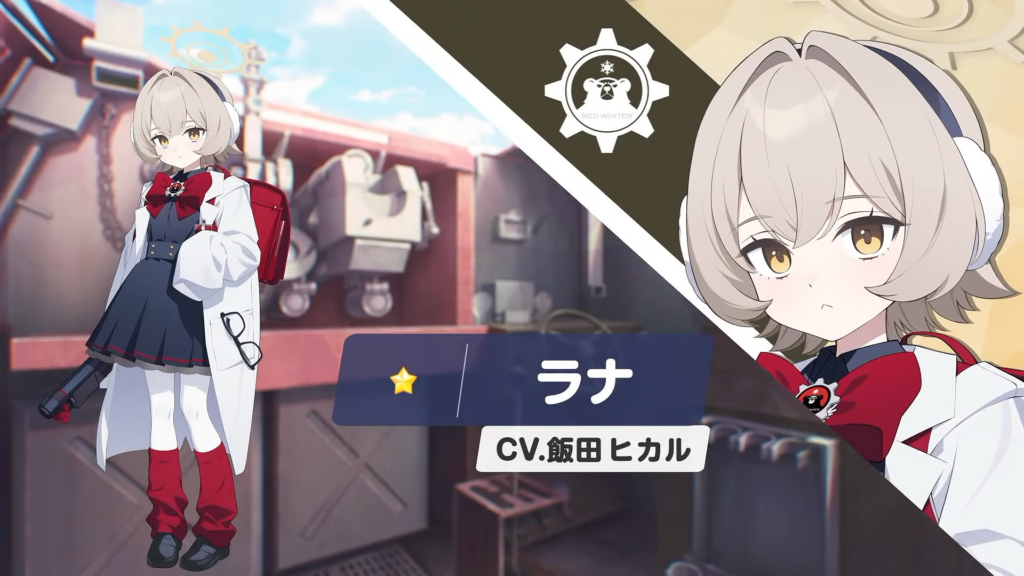
蔚藍檔案實裝了一個名為ラナ的角色。12歲,是個跳級生。所屬學校是レッドウィンター(赤冬)。
她因為犯錯而被流放到183特別クラス。至於她犯的是什麼錯?在入學考試時找出畫卡系統的破綻讓自己的分數變成4294967295。
由此可見ラナ是一個側重資訊領域的天才小孩。小姐為何不去報考ミレニアム(千年)?
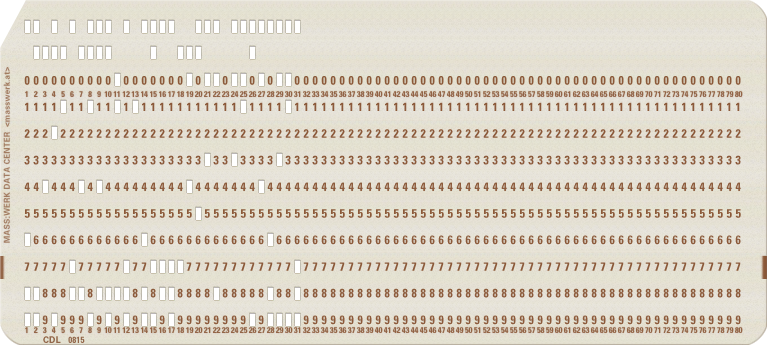
ラナ雖然是現代人,卻對於使用Punch card儲存資訊這件事情有獨鍾。
從ラナ的回憶大廳也能看到,手上抓著一張,旁邊也有一整疊。
看著打了一堆洞的卡片,自然會讓人好奇這張卡片到底儲存了什麼訊息,於是網友們去問AI,AI推理出了一套正確解答,讓ラナ的角色形象更加立體。
AI時代求解確實變方便了,如果想要求甚解,AI也基本上可以一次就把我這篇文章所介紹的所有知識呈現給使用者看。而這篇文章則是我基於自己的知識,與AI一步一步互動求出我可以接受的解答的過程。
Punch card
以物理穿孔承載資訊的卡片。最初被發明用在人口普查,搭配打字機將資料打孔於卡片對應的位置,將原本人工作業的時間驟減。今天的老牌電腦公司IBM就是以這起家的。
Punch card應用領域很廣,每個領域都對孔洞的位置與分佈有自己的定義(打在哪些位置代表什麼資訊),並藉由打字機讓輸入者明白自己在輸入什麼。
在20世紀中葉之前,許多計算機或早年的電腦被創造出來,這些機器基本上也是使用Punch card來儲存資訊。程式人員將程式打在Punch card上,要執行時把程式卡片與資料卡片餵進機器,然後機器會將程式的輸出資料印在紙上(給人類看的報表)或打孔在空白卡片上(可作為日後輸入電腦的資料)。
這相當於程式碼放在一個檔案,而輸入的資料放在另一個檔案中,電腦執行程式後可以將結果輸出於螢幕,或是輸出在另外一份檔案。Punch card就是那個年代的檔案。
儘管使用磁性長期儲存資料的模式在60年代已經被發明,直到7、80年代仍然有不少運作中的機器使用卡片輸入。
現在Punch card作為儲存媒介已經過時,但各位考試時的畫卡等等,使用光學辨識代替打洞的技術,依然是當年Punch card的概念延伸。
而且畫卡還能用橡皮擦塗改,打孔打錯只能換一張新的。
那麼話說回來,早年的電腦是怎麼解讀Punch card的?
80行的Punch card與EBCDIC編碼
由於卡片是實體,所以尺寸標準是很重要的。

Source: MdeVicente, CC0, via Wikimedia Commons
電腦世界最主流的卡片樣式是IBM的80行(column)樣式,一行代表一個字,每一行有12個列(row)用來進行編碼。這12列由上到下分別是:12、11、0、1、2、3、4、5、6、7、8、9。
其中0到9孔的位置會印出該數字,最上面的12、11號孔則不會寫在紙面上。
有了卡片之後,接下來是「我打的這些洞會代表什麼」,也就是所謂的編碼。 IBM的機器處理這種卡片時通常使用下列的模式:
- 空格就是該行完全不打洞,一張沒打洞的卡片是全空的。
- 數字的表示相當單純,想要表示0就打孔在「0」列,表示1就打在「1」列等等。
- 單獨打11列代表「&」;單獨打10列代表「-」。
- 為了表達英文字母與其它符號,會在一行(column)打多個孔洞。要表示A到I九個字母便於12列打孔再分別打1-9,也就是12-1代表「A」1、12-2代表「B」以此類推,J到R則是11列加1~9,剩下的八個字母則是0列加上2~9。
- 至於0-1這個組合則是代表「/」。
- 其它符號則是打兩或三孔,規則是:zone [12, 11, 0, none2] + digit [2, 3, 4, 5, 6, 7] + 8,也就是第一個洞(zone)打12或11或0或不打,第二個洞(digit)打在2到7其中一點,第三個洞則固定打在8號。
這種打卡編碼總共儲存了幾個字:
- 1:不打洞
- 12:打一個洞
- 27:英文字母與「/」,zone [12, 11, 0] + digit [1-9]
- 24:其它符號,zone [12, 11, 0, none] + digit [2, 3, 4, 5, 6, 7] + 8
總共64個字,所以一般稱之為6位元的編碼,因為64為2的6次方,可以用6個01開關完整表達這個編碼規則。
問:請問有其它符號的編碼表嗎?
Punch card在電腦時代以前就已經存在。如今已然是常識的基於電子訊號的01二進位編碼並非打孔機時期的主流思維,所以最初的打洞模式並沒有刻意做成2的次方數。可以理解成是進入電腦時代後才產生了將Punch card轉換為6位元數字的需求,打孔模式才被拓展到可以打64種字。
且因為各語言、領域使用的符號列表也大不相同,所以這個時期並不存在統一的編碼表。上述介紹的空格、數字與英文字母是眾多種編碼的最大公因數。
| Punch | 026 COMM | 026 FORT | 029 EBCD |
|---|---|---|---|
| 12 | & | + | & |
| 11 | – | – | – |
| 0-1 | / | / | / |
| 8-2 | : | ||
| 8-3 | # | = | # |
| 8-4 | @ | ‘ | @ |
| 8-5 | ‘ | ||
| 8-6 | = | ||
| 8-7 | “ | ||
| 12-8-2 | [ | ||
| 12-8-3 | . | . | . |
| 12-8-4 | ¤ | ) | < |
| 12-8-5 | ( | ||
| 12-8-6 | + | ||
| 12-8-7 | | | ||
| 11-8-2 | ] | ||
| 11-8-3 | $ | $ | $ |
| 11-8-4 | * | * | * |
| 11-8-5 | ) | ||
| 11-8-6 | ; | ||
| 11-8-7 | ^ | ||
| 0-8-2 | \ | ||
| 0-8-3 | , | , | , |
| 0-8-4 | % | ( | % |
| 0-8-5 | _ | ||
| 0-8-6 | > | ||
| 0-8-7 | ? |
後來為了適應電腦一個位元組8位元的儲存模式,IBM設計了一套8位元的二進位文字編碼,也就是EBCDIC。這種編碼作為介接打孔卡與二進位編碼,有一些一眼能看出來的分佈性質:
- 數字0-9分別對應
0xF0到0xF9 - 字母A到I對應
0xC1到0xC9、J到R是0xD1到0xD9,S到Z是0xE2到0xE9
EBCDIC的編碼空間有8個位元組,也就是可以定義最多256種字。基本EBCDIC代碼沒有對應文字的部分,可以依照各國語言的需求填空為各國專屬的字母。

Source: Blue-punch-card-front.png: Gwern derivative work: agr, Public domain, via Wikimedia Commons
EBCDIC與Punch card的對應關係
我們介紹了EBCDIC以前的打孔機編碼,而EBCDIC引入四倍大的編碼空間,則孔洞組合也必須增加,方能應付多出來的字元。
具體的打洞可能性是這樣的:
- zones [12, 11, 0, 8, 9] + digit [1, 2, 3, 4, 5, 6, 7, none]
- zone”s” 代表[12, 11, 0, 8, 9]這五種洞可以打任意個,也就是可以完全不打,也可以只打其中一孔,最多五孔全打。
- 總共的可能種類就會是$2^5 \times 8 = 256$種
但只要編號相同,對應的孔洞組合基本上就會是一致的。
搭配將EBCDIC編碼對應到卡片編碼的轉換表(EBCDIC Card Code),於是我們終於可以開始解讀ラナ的卡片了!嗎?
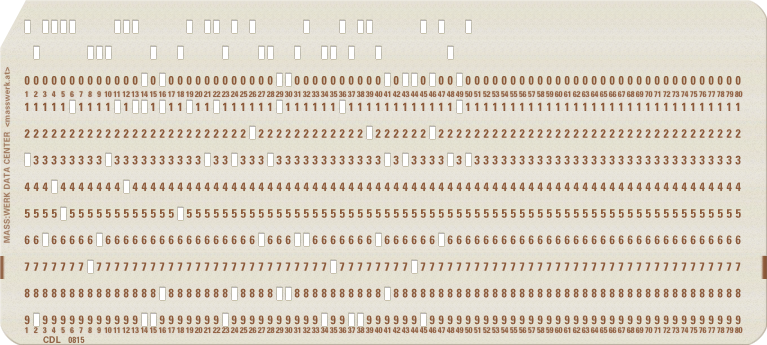
依照IBM打孔卡與EBCDIC的標準,我們可以得出解讀內容如下:
CRFDEA POLADA_R_ NA CAR. BOL_YOF RPARIBO, TXISFL/C
詳細解讀
| Punch | EBCDIC |
|---|---|
| 12-3 | 0xC3 "C" |
| 11-9 | 0xD9 "R" |
| 12-6 | 0xC6 "F" |
| 12-4 | 0xC4 "D" |
| 12-5 | 0xC5 "E" |
| 12-1 | 0xC1 "A" |
| none | 0x40 " " |
| 11-7 | 0xD7 "P" |
| 11-6 | 0xD6 "O" |
| 11-3 | 0xD3 "L" |
| 12-1 | 0xC1 "A" |
| 12-4 | 0xC4 "D" |
| 12-1 | 0xC1 "A" |
| 0-9-1 | 0x21 |
| 11-9 | 0xD9 "R" |
| 0-8-1 | 0x69 |
| none | 0x40 " " |
| 11-5 | 0xD5 "N" |
| 12-1 | 0xC1 "A" |
| none | 0x40 " " |
| 12-3 | 0xC3 "C" |
| 12-1 | 0xC1 "A" |
| 11-9 | 0xD9 "R" |
| 12-8-3 | 0x4B "." |
| none | 0x40 " " |
| 12-2 | 0xC2 "B" |
| 11-6 | 0xD6 "O" |
| 11-3 | 0xD3 "L" |
| 0-8-1 | 0x69 |
| 0-8 | 0xE8 "Y" |
| 11-6 | 0xD6 "O" |
| 12-6 | 0xC6 "F" |
| none | 0x40 " " |
| 11-9 | 0xD9 "R" |
| 11-7 | 0xD7 "P" |
| 12-1 | 0xC1 "A" |
| 11-9 | 0xD9 "R" |
| 12-9 | 0xC9 "I" |
| 12-2 | 0xC2 "B" |
| 11-6 | 0xD6 "O" |
| 0-8-3 | 0x6B "," |
| none | 0x40 " " |
| 0-3 | 0xE3 "T" |
| 0-7 | 0xE7 "X" |
| 12-9 | 0xC9 "I" |
| 0-2 | 0xE2 "S" |
| 12-6 12-9-6 12-8-6 12-9-8-6 | 0xC6 "F"0x060x4E "+"0x0E |
| 11-3 11-9-3 11-8-3 11-9-8-3 | |
| 0-1 0-9-1 0-8-1 0-9-8-1 | |
| 12-3 12-9-3 12-8-3 12-9-8-3 | |
底線代表基本的EBCDIC無法對應到可顯示的字,包含「0-9-1」與「0-8-1」這兩種打孔組合,在EBCDIC分別為0x21、0x69。
而另外一件事是最後四個字的8、9被遮住會影響判斷。
但總之目前最大的問題是:這感覺是加密過的!
各國語言會在基本的EBCDIC保留未使用的編號放入自己的字母,定義所謂的編碼頁(Code page),包含定義西里爾字母的DKOI(ДКОИ)。但這些EBCDIC延伸的Code page是不會變動「數字、拉丁字母與部分符號」的編號的。只要我們用這種編碼模式解出拉丁字母,用其它當年的解法都會解出同樣的拉丁字母。3
那麼各位在網路上看到的「ラナ打孔卡解讀」又是怎麼來的?
最後一哩路:加密文字與西里爾字母
以下的部分與編碼的「歷史」或「業界標準」關聯不大,這個部分是「破譯密碼」。而破譯密碼如果是人工作業則需要依賴一些「靈光乍現」,而這正是AI能做得很傑出的部分:AI可以在幾秒內模擬人類可能會嘗試的數百種「靈光乍現」並找出最像正解的一種。但我會盡量以一個人類的可能思路去模擬解密的過程,輔以AI幫我釐清我不熟悉的俄文文法。
思路要延伸到俄文與西里爾字母完全只依靠一個設定:ラナ所屬的學校是捏他自蘇聯。
筆者曾經嘗試從真實世界存在過的西里爾字母打孔卡編碼著手,卻只得到同樣的問題:蘇聯的編碼依然要尊重既有的拉丁字母。
A可以當成西里爾字母А啦(參考DKOI K2),但D、L、R這種不能以字形替代西里爾字母的字穿插在句子裡要如何解?就算用發音聯想把D代換成Д、L代換Л、R代換Р,結果也是不成字的西里爾字母亂碼。
其實,從答案回頭看題目的話,這種程度的密文對密碼專家而言大概是相當簡單。但不是專家的我只能判斷說:句子裡面的A與O的分佈都像是真的母音。又或者有人能夠靈機一動,不如把西里爾字母直接依序代替拉丁字母看看?這經常是解碼不同符號系統時的第一步嘗試。
| A | B | C | D | E | F | G | H | I | J | K | L | M | N | O | P | Q | R | S | T | U | V | W | X | Y | Z | ||||||
| А | Б | В | Г | Д | Е | Ж | З | И | Й | К | Л | М | Н | О | П | Р | С | Т | У | Ф | Х | Ц | Ч | Ш | Щ | Ъ | Ы | Ь | Э | Ю | Я |
儘管有些字母組合確實有相近音位,但這份表只是機械式的對應關係。
西里爾字母表的順序與Unicode Basic Russian alphabet相同,不包含俄語字母表的Ё。
需注意的是上面列出了32個西里爾字母,比拉丁字母多6個,所以最後六個ЪЫЬЭЮЯ無法對應。
經過轉換後,會變成:
ВСЕГДА ПОЛАГА_С_ НА ВАС. БОЛ_ШОЕ СПАСИБО, УЧИТЕЛ/В
很棒,因為第一個字”ВСЕГДА”真的是俄文單字!所以這個思路切中核心了。接下來是解決沒辦法解碼的底線部分,以及釐清最後四個字母是否會受ラナ小手手遮住8、9孔的影響。
我們大膽假設底線必定是”ЪЫЬЭЮЯ”裡面的字。許多人幾乎不會俄文,所以大膽使用google把第二個單字前面的”ПОЛАГА”打上去看看會有什麼推薦結果?結果指向一個字”ПОЛАГАЮСЬ”,還真對上了。所以打孔卡的0-9-1可能就是對應”Ю”、0-8-1應該對應到”Ь”。
| 0-8-1 | 0-9-1 | ||||
| Ъ | Ы | Ь | Э | Ю | Я |
把這延伸到”БОЛ_ШОЕ”可以得到”БОЛЬШОЕ”,還真的對上了。
現在把眼光轉到最後一個單字”УЧИТЕЛ/В”,這明顯不太對吧?要釐清ラナ的小手手遮到8、9孔會影響什麼,最快的方法就是列出有無8與有無9共四種組合。
| Punch | EBCDIC | 候選字母 |
|---|---|---|
| 12-6 12-9-6 12-8-6 12-9-8-6 | 0xC6 "F"0x060x4E "+"0x0E | Е + |
| 11-3 11-9-3 11-8-3 11-9-8-3 | | Л $ |
| 0-1 0-9-1 0-8-1 0-9-8-1 | | / Ю Ь |
| 12-3 12-9-3 12-8-3 12-9-8-3 | | В . |
比較有譜的是”УЧИТЕЛЬ.”或”УЧИТЕЛЮ.”,最後一個點正好當整句的結尾。
而兩邊不管選哪個都是同一個字的不同格變化。因為不懂俄文所以請教AI,這個地方用”УЧИТЕЛЬ”比較適合。 至此終於整出了完整的句子
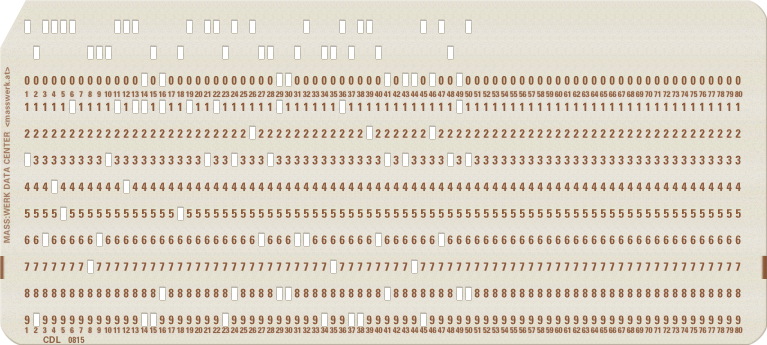
ВСЕГДА ПОЛАГАЮСЬ НА ВАС. БОЛЬШОЕ СПАСИБО, УЧИТЕЛЬ.
順帶我們可以猜出這張Punch card的全貌:
另外一張Punch card與意外的結局
ラナ的回憶大廳有另外一疊卡片,最上面的卡片可以認出孔洞,而且也沒有被遮擋,所以也可以解出:
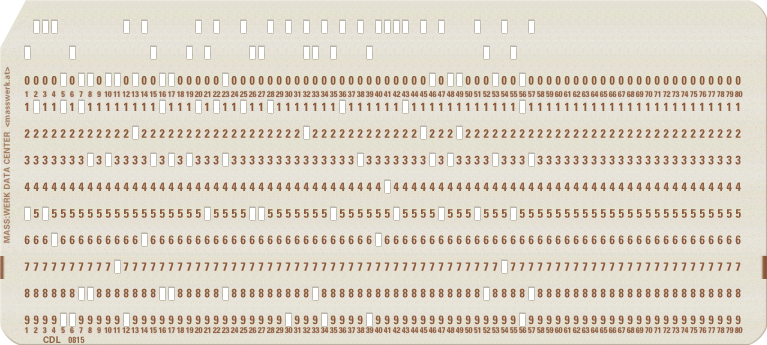
NAEF_R_, TXISFL_, LANA, ANNA I kQINA CRFDEA BTETS EQTGN_.
一樣有一些無法直接解碼的孔洞組合。這次出現了新的組合「12-11-2」,這組其實可以對應到小寫拉丁字母k。
但如果直接用之前得到的各種結論,我們會得到:
НАДЕЮСЬ, УЧИТЕЛЬ, ЛАНА, АННА И кРИНА ВСЕГДА БУДУТ ДРУЖНЮ.
先不說Punch card時代主流的大寫字母串怎麼會出現小寫字母。
我們先逐一解析各個字可以發現:
- УЧИТЕЛЬ:老師(文法上是男性)
- ЛАНА :LANA
- АННА:ANNA
既然檔案玩家知道ラナ所在的這個群體183特別班級包含了ラナ、アンナ、エリナ,那”кРИНА”是不是應該其實要是ERINA?
要發出E的音,又不在頭26西里爾字母的就只有Э了,所以我們找出這個神奇的「12-11-2」打孔對應到了Э。
| 0-8-1 | 12-11-2 | 0-9-1 | |||
| Ъ | Ы | Ь | Э | Ю | Я |
最後的最後又出事了,最後的單字”ДРУЖНЮ”並不符合此處俄語的文法變化,最合適的是”ДРУЖНЫ”。
也就是雖然是之前推測Ю的孔位0-9-1,但正確答案卻是之前沒看過的Ы。因為我們看到的Punch card就只有這兩張,沒有更多線索了。
這部分實在不知道如何解釋,或者0-9-1被對應到兩種字母,或者是與烏克蘭語搞混,又或者單純真的畫錯了也說不定。
畢竟Punch card編碼已經屬於考古範圍,能夠到最後一個字才出問題已經很棒了。
所以最終結果就如同各位在網路上看到的那樣:
НАДЕЮСЬ, УЧИТЕЛЬ, ЛАНА, АННА И ЭРИНА ВСЕГДА БУДУТ ДРУЖНЫ.
結語
由於網際網路時代以前,Punch card已經是幾乎被淘汰的儲存媒介,網路上有關Punch card時代琳瑯滿目的編碼模式只能窺見鳳毛麟角。
這篇文章所介紹的只是Punch card最常見的一種編碼手段,應用於IBM所生產的大多數機器。雖然這些機器包含好幾種對特殊符號表的詮釋方式(比如繕寫商業文件時常用的符號,以及繕寫FORTRAN程式時常用的符號不會是同一張表),不過這次解析的只是一般的句子,符號表只需要基本的逗號與句號即可。
而一旦對1960年代的電腦生態有基本概念,知道當時Punch card還是很主流的儲存模式,那麼對於當時的程式語言存在的一些特質就能得到解釋。筆者舉幾個例子:
- 慣用大寫字母。最早期的編碼根本沒有小寫字母的存在,就算EBCDIC與ASCII將小寫字母正式納入編碼空間,用來編寫小寫字母的孔洞數量需要三孔。因為Punch card是物理打洞,越多洞會造成卡片的物理特性變得脆弱(Lace card),導致高速讀卡時被勾破等等。
- 每行字數受限。很容易理解,當年一張Punch card就是80個column,對應就是80個字。
- 最後幾個字存放Line number作為排序。因為一張卡是一個句子,如果要寫100行程式就是要100張卡,如果卡片順序被打亂將會毀掉程式。所以這個年代的程式卡會保留最後幾個字,打上數字以表示先後順序。4而且每一張卡可能會隔數萬號,以便日後插入更多程式碼在中間。
- 存在替代符號。如同先前所述,當年的符號表有其侷限,並非普世共通。像是ALGOL最早定義了許多數學常用的運算子×÷≤≥等等,但後來定義這些符號可使用
* / <= >=等符號代替。5而許多程式語言的根基C語言也定義了多種「Trigraph」以三個符號代替一個符號,比如讓??=代替#等等。6
這次探索也讓我感受到AI的強項以及弱點。有些推理能力比較遜色的AI會在某些問題上幻想出一個漂亮答案,但當我詢問源頭時,AI給的網址內容根本沒有它提過的事情。而AI強在迅速搜尋的能力,畢竟面對一個不知道怎麼下關鍵字搜索的考古議題,AI可以讀懂人類模糊的指令並找出最好的方向,著實讓我省下許多時間。
最後是比較可惜的是完全無法底定這六個西里爾字母ЪЫЬЭЮЯ的打孔邏輯。窮竟現有網路資源,我基本上確定這套編碼或加密法則是某群人自己聯想設計出來的,所以除非設計者公開,應該是無法得到正確解答了。
最後的最後,如果你也想要在現實世界展現這份復古浪漫,除了找來一台早年的打字機,何不試試看找回你考試用的2B鉛筆呢?
延伸話題:中文與Punch card
實際上Punch card的時代不會使用卡片儲存中文資訊,在EBCDIC的中文編碼頁制定起來時已經不會使用Punch card儲存資訊了。不過我們當然還是可以模擬的。
因為中文數量眾多,所以EBCDIC使用兩個位元組來代表中文,但因為這些位元組會與原先的符號有所衝突,所以需要用0x0E "Shift out"宣告後面的字需要解釋成雙位元組字元,用0x0F "Shift in"宣告後面的字回歸到單位元組字元。
我們使用台灣中文的基本EBCDIC編碼頁CP937舉例,我想要輸入「這是我的第1張Punch card。」,則會變成下面的編碼:
| 字元 | EBCDIC | Punch |
|---|---|---|
0x0E | 12-9-8-6 | |
| 這 | 0x58 | 12-11-9-8 |
0xD4 | 11-4 | |
| 是 | 0x52 | 12-11-9-2 |
0xD1 | 11-1 | |
| 我 | 0x4F | 12-8-7 |
0x5C | 11-8-4 | |
| 的 | 0x51 | 12-11-9-1 |
0x9C | 12-11-8-4 | |
| 第 | 0x58 | 12-11-9-8 |
0x69 | 0-8-1 | |
0x0F | 12-9-8-7 | |
| 1 | 0xF1 | 1 |
0x0E | 12-9-8-6 | |
| 張 | 0x57 | 12-11-9-7 |
0x4F | 12-8-7 | |
0x0F | 12-9-8-7 | |
| P | 0xD7 | 11-7 |
| u | 0xA4 | 11-0-4 |
| n | 0x95 | 12-11-5 |
| c | 0x83 | 12-0-3 |
| h | 0x88 | 12-0-8 |
0x40 | none | |
| c | 0x83 | 12-0-3 |
| a | 0x81 | 12-0-1 |
| r | 0x99 | 12-11-9 |
| d | 0x84 | 12-0-4 |
0x0E | 12-9-8-6 | |
| 。 | 0x43 | 12-0-9-3 |
0x41 | 12-0-9-1 | |
0x0F | 12-9-8-7 |
可以窺見卡片被打了許多位置相近的孔洞,較難承受高速讀卡。也就是所謂的「Lace card」。
參考資料
https://homepage.divms.uiowa.edu/~jones/cards/codes.html
https://en.wikipedia.org/wiki/Punched_card
https://nvlpubs.nist.gov/nistpubs/Legacy/FIPS/fipspub14-1-May1980.pdf
https://meganorm.ru/Data2/1/4294833/4294833644.pdf
https://meganorm.ru/Data2/1/4294827/4294827229.pdf
https://unicode.org/Public/18.0.0/charts/nameslist/0400/
https://en.cppreference.com/cpp/language/operator_alternative
https://www.masswerk.at/keypunch
- 我們會用「12-1」代表同時打12與1兩孔。 ↩︎
- 以「none」代表不打孔。 ↩︎
- 當時除了EBCDIC還有另一套編碼,就是今日廣泛使用的ASCII。當年尚處於Punch card時代,ASCII也有一套與Punch card之間的轉換模式,在ANSI X3.26被正式定義。為了兼容既有的大量卡片,數字與英文字母等基本字元依然維持原本的打孔模式。只是在電腦裡面被讀作不同的號碼,比如「A」打孔12-1,故12-1轉為EBCDIC是
0xC2 "A",在ASCII則是0x41 "A"。 ↩︎ - 當然,排序卡片是機器的工作。 ↩︎
- 大致可以想像成,ALGOL年代定義多種來自數學領域的運算子,並且設計一套符號表,讓ALGOL程式卡的孔洞組合代表它自己的運算子。但是基本符號表在1960年代已經大致底定,一般電腦無法滿足ALGOL的特殊符號表,所以需要制定符號替代的規則。而現代程式語言則是直接基於普世通用的編碼表ASCII與Unicode從頭定義運算子,並非於語法層面替代成原運算子。 ↩︎
- 儘管上一個註腳說基本符號表在1960年代大致底定,但C語言使用到了那些基本符號以外的符號。Trigraph所替代的九個符號:
# \ ^ [ ] | { } ~。延續許多C語言特性的C++則於C++17標準正式移除Trigraph。 ↩︎